GPU服务器在海南高性能计算场景中的应用与配置要点
海南自贸港建设提速以来,本地高校、科研院所和AI企业的高性能计算需求增长明显。以三亚崖州湾科技城、海口复兴城产业园为例,不少团队开始从传统的机架式服务器集群转向GPU异构算力平台,用于深度学习训练、遥感影像处理、海洋气象建模等场景。但GPU服务器的选型与部署逻辑,和通用服务器有本质区别,踩坑的团队不在少数。
GPU服务器与传统服务器的架构差异
普通塔式服务器或通用机架式服务器以CPU为核心,侧重逻辑运算和IO吞吐;而GPU服务器的核心在于高密度并行计算。一台8卡GPU服务器满载功耗可达6kW以上,对供电、散热、PCIe拓扑的要求完全不同。海南气候高温高湿,机房PUE控制难度大,如果照搬北方数据中心的部署方案,很容易出现GPU降频甚至宕机。
另一个常见误区是存储与网络配置。GPU训练任务对数据读取带宽极为敏感,若仍采用普通SATA SSD和千兆网络,GPU利用率可能长期低于40%。建议至少配置NVMe SSD阵列和25G/100G RDMA网络。
海南场景下的配置要点
结合本地实际,以下配置维度值得重点关注:
- 散热方案:优先选择支持液冷或后门热交换器的机柜,风冷机型需确保机房送风温度≤22℃
- GPU选型:训练场景建议NVIDIA A100/H100系列;推理场景可考虑L40S或国产加速卡,兼顾成本与合规
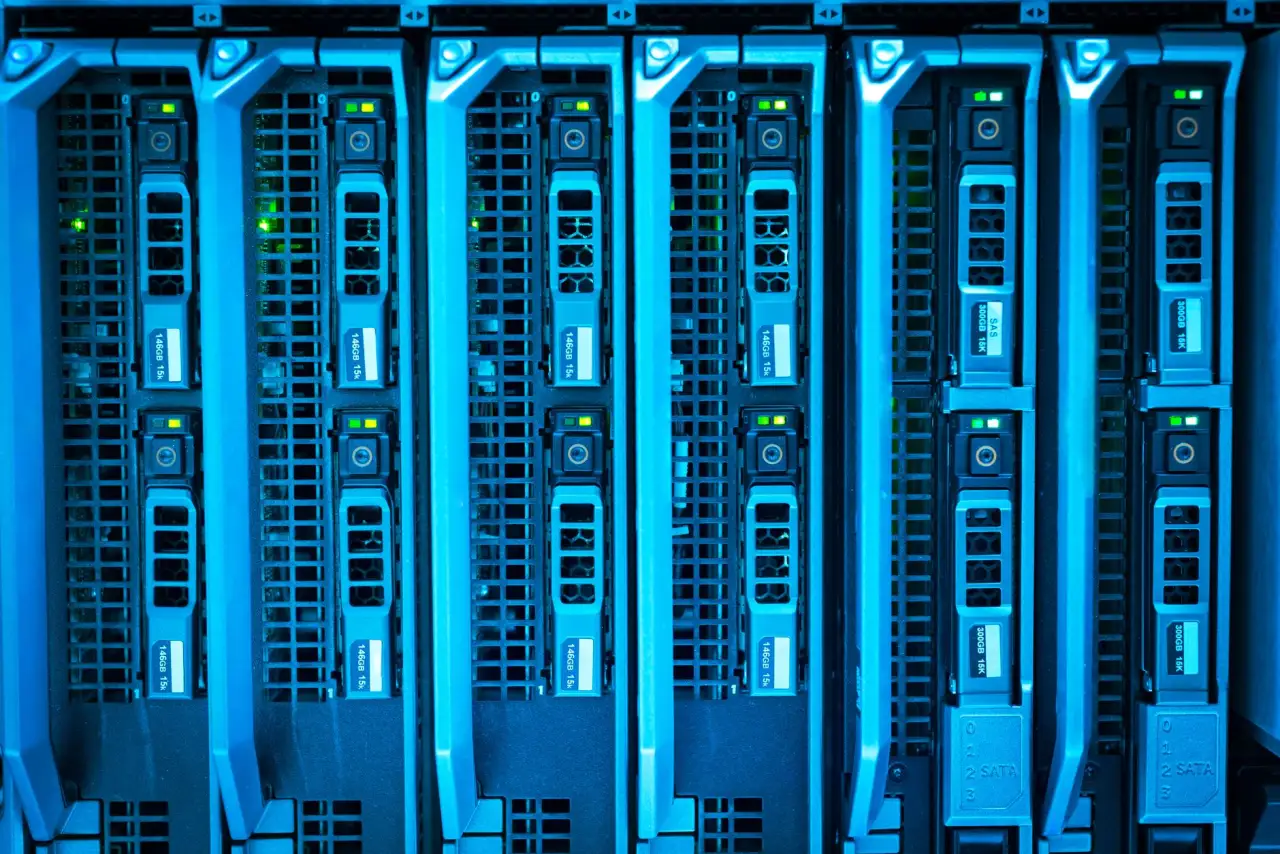
- 节点形态:高密度场景可用刀片服务器配合GPU扩展模块,灵活性要求高的团队则可选4U机架式GPU服务器
- 边缘侧协同:对于港口、海上平台等现场推理需求,可搭配边缘计算服务器做前置处理,减少回传压力
供电方面,单机柜功率密度超过15kW时,需提前与机房方确认市电容量和UPS冗余。海南部分园区已支持双路市电+柴发备份,但改造周期较长,建议在采购GPU服务器前就完成电力评估。
落地实践中的三个建议
第一,先做算力需求建模。不是所有任务都需要8卡A100,小规模微调用单卡A6000甚至RTX 6000 Ada也能跑通,避免过度投资。第二,重视集群调度层,Slurm或Kubernetes配好GPU亲和性策略,否则多用户抢占会让效率大打折扣。第三,海南本地运维人才相对稀缺,建议选择提供原厂级售后和远程带外管理的品牌方案,降低日常维护门槛。
从趋势看,GPU服务器的液冷渗透率正在快速上升,海南多个新建智算中心已把液冷作为标配。对于正在规划算力平台的团队,把散热和电力前置到选型阶段,比后期改造划算得多。