GPU服务器在华南人工智能产业中的应用现状与技术趋势
华南地区聚集了全国超三成的人工智能企业,从深圳的计算机视觉集群到广州的自动驾驶研发中心,算力需求正以每年翻倍的速度增长。企业面对的问题很现实:模型参数从亿级跃升到千亿级,传统通用服务器跑一次训练要数周,项目周期根本等不起。这就把GPU服务器推到了基础设施的核心位置。
从训练到推理:GPU服务器的部署形态分化
不同场景对硬件形态的要求差异很大。大规模预训练任务通常采用机架式服务器,4U或8U高度内集成8张高功耗GPU卡,通过NVLink和InfiniBand组网实现多机多卡并行。而一些老牌制造企业的AI质检产线,机房空间有限、预算敏感,反而更倾向塔式服务器——单卡或双卡配置,部署灵活,运维门槛低。
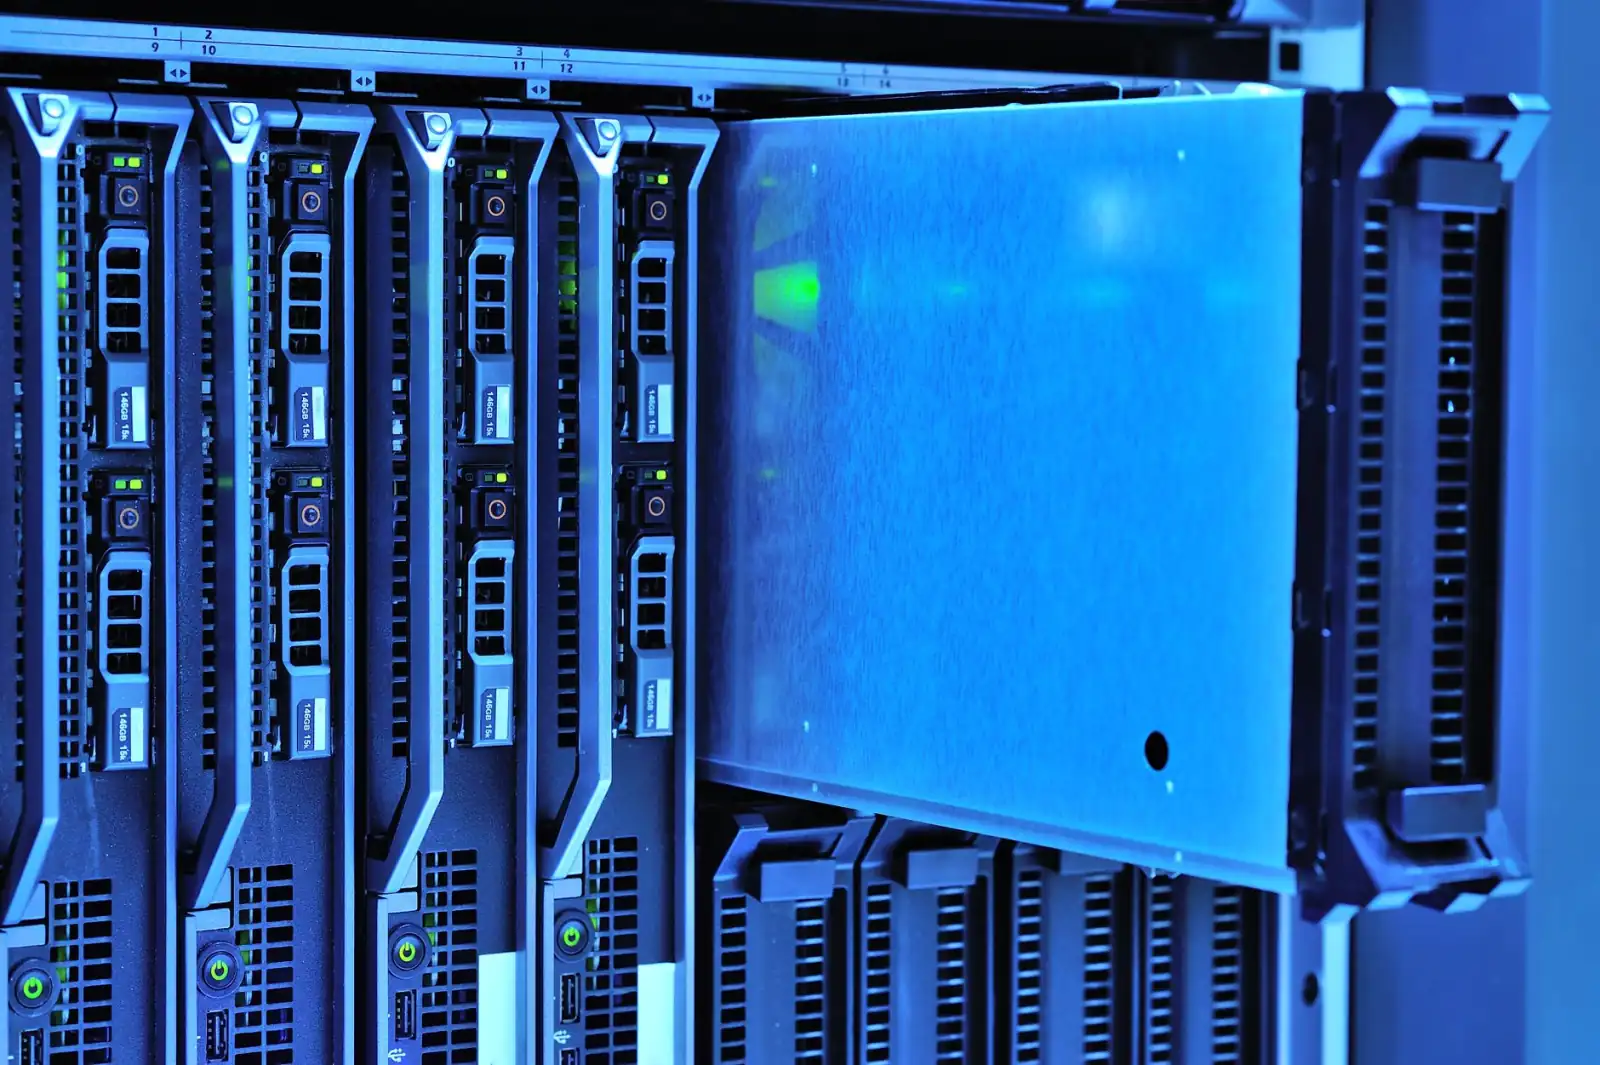
值得注意的是,刀片服务器在华南的金融和电信行业数据中心仍有不可替代的地位。高密度刀片机箱配合GPU刀片模块,能在有限机柜空间内实现更高的算力密度,同时共享电源和散热系统,PUE控制更优。某深圳金融科技公司去年将风控模型推理集群从机架式迁移到刀片架构后,单机柜算力提升了约40%。
边缘侧的新战场
华南制造业密集,工厂车间的AI视觉检测对延迟极其敏感。把数据传回云端推理再返回结果,网络抖动可能造成产线停机。边缘计算服务器因此快速渗透——在靠近产线的机柜中部署低功耗GPU边缘节点,推理延迟从百毫秒级压缩到10毫秒以内。
这类边缘设备通常采用半宽或短深度机架式设计,功耗控制在300W以下,支持宽温运行。广州一家面板厂在质检环节部署了12台边缘GPU节点,缺陷检出率提升的同时,带宽成本下降了60%以上。
选型与运维的实践要点
企业采购GPU服务器时,以下几个维度需要重点评估:
- GPU互联拓扑:NVLink桥接与PCIe Switch方案在多卡通信效率上差距可达数倍,训练任务必须关注
- 散热方案:华南夏季高温高湿,风冷机型的进风温度裕量要留足,液冷方案在8卡以上密度时经济性开始显现
- 供电冗余:单台8卡GPU服务器满载功耗可超6kW,机房配电和UPS容量需提前核算
- 管理接口:IPMI/Redfish的完善程度直接影响大规模集群的运维效率
另一个容易被忽视的点是GPU驱动与CUDA版本的统一管理。华南某AI创业公司曾因不同批次服务器的驱动版本不一致,导致分布式训练频繁中断,排查耗时超过一周。建议在采购阶段就要求供应商提供标准化的软件栈镜像。
应用前景
随着华南各省市智算中心陆续落地,GPU服务器的采购模式也在变化——从企业自建转向算力租赁和混合部署。对于中小型AI团队,按需租用GPU服务器资源比一次性采购更划算。而在智能制造、智慧港口、跨境电商推荐系统等场景中,边缘计算服务器与中心GPU集群的协同架构将成主流。算力不是越多越好,匹配业务节奏的弹性部署才是关键。